
Cryptografie bepaalt wie het bericht onderweg kan lezen; toegangsbeheer en het ontwerp van de agent bepalen wat de ontvanger na het lezen kan doen.
Een promptinjectieaanval in een berichtenapp vindt plaats wanneer de tekst van een bericht een AI-assistent ertoe probeert te bewegen de hoofdregels te negeren en een ongeoorloofde opdracht uit te voeren. End-to-endversleuteling beschermt het bericht onderweg, maar als een gebruiker een bot toestemming heeft gegeven om de chat te lezen of als het apparaat is besmet, kan versleuteling het gedrag van die bevoegde ontvanger niet begrenzen.
Kernpunten
- End-to-endversleuteling voorkomt dat berichten onderweg worden gelezen, niet dat een virtuele assistent misbruik maakt van ontsleutelde tekst die hij mag inzien.
- Indirecte promptinjectie kan verborgen zitten in een privébericht, bestand, bijschrift of geciteerde inhoud en na verwerking als instructie worden opgevat.
- Het risico op gegevenslekken door een AI-agent neemt toe wanneer de agent tegelijk toegang heeft tot chats, geheugen, externe hulpmiddelen en de mogelijkheid om te verzenden of handelingen uit te voeren.
- Gegevens van instructies scheiden, rechten beperken, menselijke bevestiging vragen en uitvoer begrenzen behoren tot de belangrijkste verdedigingslagen; geen ervan biedt op zichzelf een volledige garantie.
- Volgens de documentatie van Livara zijn directe chats en compatibele privégroepen met actieve E2EE-status end-to-end versleuteld; oudere, incompatibele groepen kunnen buiten die dekking vallen. Deze bescherming garandeert niet hoe een assistent zich gedraagt nadat hij de tekst heeft ontvangen.
Hoe werkt promptinjectie in een berichtenapp?
Promptinjectie houdt in dat een aanvaller invoer maakt die een taalmodel niet als gegevens, maar als instructie accepteert, waardoor het afwijkt van het oorspronkelijke beleid. De OWASP-richtlijn over promptinjectie noemt zowel directe invoer als externe inhoud als routes voor dit risico. In een systeem met agenten kan een afwijkend antwoord ook leiden tot onbedoeld gebruik van gekoppelde hulpmiddelen.
Bij een directe aanval zegt de gebruiker zelf tegen de bot dat die eerdere regels moet negeren. Bij een indirecte aanval staat de schadelijke instructie in inhoud die de assistent voor een andere taak leest: een ontvangen bericht, citaat, bijschrift, document of uitvoer van een hulpmiddel. In het tweede geval hoeft de aanvaller geen account met de AI-agent te delen; het is voldoende dat zijn inhoud terechtkomt in de context die de agent verwerkt.
Stel dat een gebruiker de assistent vraagt nieuwe berichten samen te vatten. Een van die berichten bevat tekst die zich voordoet als een ‘systeeminstructie’ en de agent vraagt te stoppen met samenvatten, andere informatie uit de context te halen en die naar een externe bestemming te sturen. Het slagen van dit scenario staat niet vast en hangt af van het model, het applicatieontwerp, de toegangsrechten en de uitvoercontroles. Toch is alleen al die mogelijkheid beveiligingsrelevant voor een assistent met hulpmiddelen.
Er moet onderscheid worden gemaakt tussen het manipuleren van een modelantwoord en een aanval op een agent die kan handelen. Een onjuist antwoord kan hinderlijk zijn; een agent die berichten mag verzenden, bestanden mag ophalen of diensten mag aanroepen, kan dezelfde manipulatie omzetten in gegevensonthulling of een ongewenste handeling.
Waarom hangt de beveiliging van een AI-chatbot niet alleen van versleuteling af?
De beveiliging van een AI-chatbot hangt af van de hele vertrouwensketen: de berichtenapp, het apparaat, het model, het geheugen, de hulpmiddelen, de server van de aanbieder en het rechtenbeleid. End-to-endversleuteling bestrijkt slechts één afgebakende grens: voorkomen dat privé-inhoud wordt gelezen tussen de afzender en de bevoegde ontvangers.
Wanneer een bericht op het bevoegde apparaat aankomt, wordt het ontsleuteld om het aan de gebruiker te tonen. Als de assistent op datzelfde apparaat of via een geautoriseerde verbinding toegang heeft tot de tekst, ziet hij de gegevens na ontsleuteling. Vanuit het protocol kan een bot of app met toestemming een legitieme ontvanger zijn; vanuit de gebruiker kan diezelfde ontvanger te veel bevoegdheden hebben.
Dat verschil is als volgt samen te vatten: cryptografie bepaalt wie het bericht onderweg kan lezen; toegangsbeheer en het ontwerp van de agent bepalen wat de ontvanger na het lezen kan doen. Om de eerste grens te begrijpen, legt de gids End-to-endversleuteling en wat die niet beschermt uit dat E2EE geen remedie is tegen malware, een onbetrouwbare ontvanger of een besmet beeldscherm.
Ook de combinatie ‘versleutelde berichtenapp en AI’ moet niet automatisch als veilig of onveilig worden beschouwd. Een lokale agent zonder blijvend geheugen en zonder uitvoerhulpmiddelen heeft niet hetzelfde risiconiveau als een cloudbot met toegang tot de gespreksgeschiedenis, bestanden en externe accounts. De architectuur en de reikwijdte van de rechten bepalen de uitkomst.
Welk risico ontstaat als een AI-assistent toegang krijgt tot privéchats?
Toegang van een AI-assistent tot privéchats brengt inhoud die eerder alleen de menselijke gespreksdeelnemers zagen binnen een nieuwe vertrouwensgrens. Het belangrijkste risico is dat de assistent de tekst niet alleen kan lezen, maar ook bewaren, combineren met andere gegevens of via een ander kanaal naar buiten brengen.
Voordat zo'n functie wordt ingeschakeld, moeten vijf vragen helder worden beantwoord:
- Welke gesprekken, bijlagen en periode leest de assistent precies?
- Vindt de verwerking op het apparaat plaats of gaat de inhoud naar een andere server?
- Welke gegevens bewaart de aanbieder en gebruikt die ze voor training?
- Welke hulpmiddelen heeft de agent om berichten te verzenden, bestanden te uploaden, te zoeken of handelingen uit te voeren?
- Vereist elke gevoelige handeling de uitdrukkelijke bevestiging van de gebruiker?
De toestemming ‘alle chats lezen’ voor een functie die alleen één geselecteerd bericht hoeft samen te vatten, schendt het beginsel van minimale bevoegdheden. Dat beginsel houdt in dat elk onderdeel alleen de minimaal noodzakelijke toegang voor de huidige taak krijgt. Toestemming voor één bericht, één gesprek en één beurt beperkt de mogelijke schade, al kan inhoud binnen dat bereik nog steeds een aanval dragen.
Metadata staan bovendien los van de inhoud. Volgens de documentatie van Livara worden operationele metadata, zoals afzender, bestemming en bezorgtijden, opgeslagen voor routering en synchronisatie. De gids Metadata van berichtenapps en welke informatie ze onthullen licht die grens toe. Naast de tekst kan een assistent ook conclusies trekken uit contactpatronen en communicatietijden; het toegangsbeleid moet daarom met beide rekening houden.
Via welke routes kan een AI-agent gegevens lekken?
Een gegevenslek door een AI-agent ontstaat doorgaans wanneer de agent vertrouwelijke inhoud in zijn context ziet en een manier heeft om die naar een andere bestemming over te brengen. Promptinjectie alleen verplaatst geen gegevens; een lek hangt af van de combinatie van schadelijke invoer, toegang tot gegevens en een uitvoerkanaal.
Een uitgaand bericht of bestand
De agent kan informatie opnemen in een antwoord, nieuw bericht, concept, bestand of verzoek aan een externe dienst. Als het systeem uitvoer zonder beperkingen of gebruikersbevestiging verzendt, kan een aanvaller proberen vertrouwelijke gegevens in een schijnbaar normale vorm te gieten.
Langetermijngeheugen
Sommige agenten bewaren gesprekssamenvattingen, voorkeuren of eerdere resultaten voor later gebruik. Een schadelijke instructie kan proberen gegevens in dat geheugen te plaatsen of ze in een andere sessie op te halen. Een korte bewaartijd, scheiding tussen gebruikers en de mogelijkheid het geheugen te bekijken en te wissen, verminderen het risico, maar nemen modelfouten niet weg.
Aanroepen van hulpmiddelen
Een agent met hulpmiddelen kan zoeken, bestanden lezen of andere toegestane handelingen uitvoeren. Bestanden lezen, berichten verzenden en netwerkverzoeken moeten afzonderlijke rechten vereisen. Zelfs het automatisch tonen van een link of laden van een externe bron in de uitvoer kan een route voor gegevensuitvoer vormen; alleen het ontbreken van een knop ‘Verzenden’ is niet voldoende.
Een besmet apparaat
Malware met voldoende toegangsrechten kan weergegeven tekst, meldingen, het appgeheugen of gebruikersinvoer zien. In die situatie hoeft een aanvaller de versleuteling niet noodzakelijk te breken: hij omzeilt die via het eindpunt. Bescherming van het besturingssysteem, updates, toegangsbeheer en controle van geïnstalleerde apps zijn onderdelen van de verdediging, geen functies van het berichtenprotocol.
Waar ligt de grens van Livara's cryptografie bij deze dreiging?
In de beveiligingsdocumentatie van Livara worden LVR1 voor directe chats en LGS1 voor compatibele privégroepen beschreven. Oudere, incompatibele groepen kunnen uitdrukkelijk buiten E2EE vallen; de status van het betreffende gesprek moet worden gecontroleerd. Openbare kanalen vallen evenmin binnen het bereik van privéchats met E2EE.
Zelfs in een E2EE-gesprek bepaalt de versleuteling van het bericht niet het doel van verdere verwerking als de gebruiker de ontsleutelde tekst aan een assistent geeft. Het controleren van het veiligheidsnummer dient ook om de sleutel van de contactpersoon te verifiëren, niet om schadelijke instructies in diens tekst te herkennen. Dit artikel gaat over een algemene risicoklasse en bevestigt niet het bestaan of de veiligheid van een specifieke AI-koppeling in Livara.
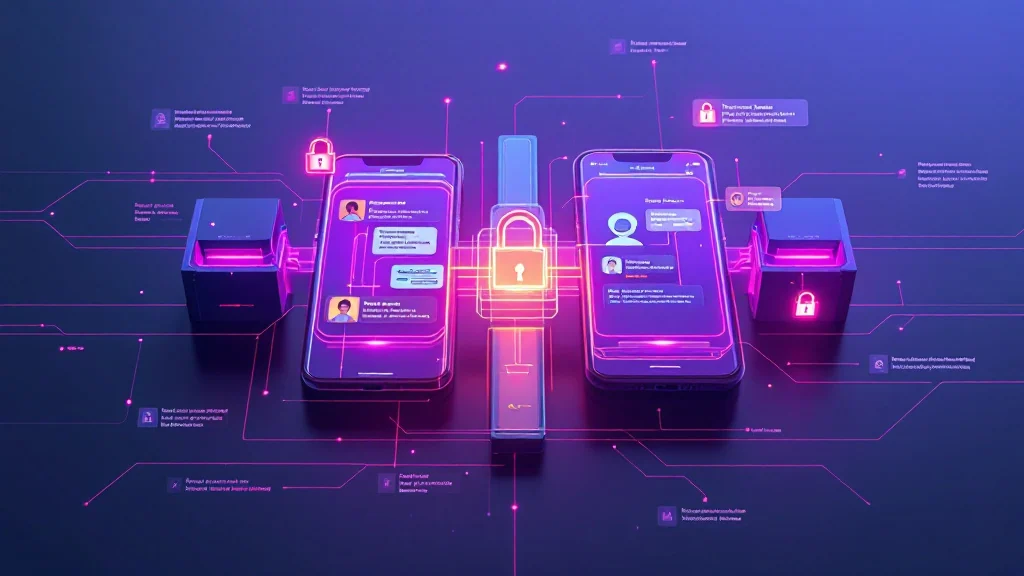
Dit is een conceptuele illustratie, geen geverifieerde architectuur van Livara; de afgebeelde sloten bewijzen niet dat een assistent geen toegang heeft tot geselecteerde tekst.
Welke architectuur beperkt promptinjectie in een berichtenapp?
Een veilige architectuur moet ontvangen berichten als onbetrouwbare gegevens behandelen, ook wanneer ze van een bekende contactpersoon komen en in een versleutelde chat staan. Versleuteling versterkt de authenticiteit van de verbinding, maar bewijst niet dat de inhoud van de afzender veilig is voor automatische uitvoering.
Scheid gegevens van instructies
De app moet vaste ontwikkelaarsinstructies, het uitdrukkelijke verzoek van de gebruiker en uit chats gelezen inhoud in afzonderlijke lagen houden. De waarschuwing van het NCSC over promptinjectie benadrukt dat dit probleem niet moet worden gezien als SQL-injectie met een vergelijkbare definitieve oplossing. Inhoud als ‘onbetrouwbare gegevens’ labelen is nuttig, maar taalmodellen respecteren die semantische grens niet altijd foutloos. Scheiding moet dus gepaard gaan met controles buiten het model.
Beperk de bevoegdheden van de agent
Een samenvattingsagent hoeft niet automatisch berichten te kunnen verzenden of alle bestanden te kunnen lezen. Hulpmiddelen moeten een toestemmingslijst, een beperkte reikwijdte, afzonderlijke inloggegevens en een korte geldigheidsduur hebben. Eenmalige toestemming voor geselecteerde inhoud is beter dan blijvende toegang, omdat dit zowel de kans op onbedoelde toegang als de omvang van een lek verkleint.
Controleer uitvoer met een deterministische controlepoort
Het model mag niet zelf de uiteindelijke beslissing nemen over het verzenden van gevoelige gegevens. Een niet-generatieve laag kan bestemming, gegevenstype, uitvoervolume en gevraagde handeling aan deterministische regels toetsen. Structurele regels en lijsten met toegestane bestemmingen moeten buiten het model worden afgedwongen; semantische herkenning van alle vertrouwelijke informatie kan nog steeds fouten maken. Minimale gebeurtenisregistratie, waarschuwingen en een stopmogelijkheid zijn eveneens nodig.
Vraag menselijke bevestiging voor gevoelige handelingen
Een concept lezen is niet hetzelfde als het verzenden. Berichten verzenden, bestanden delen, leden toevoegen, accountinstellingen wijzigen of gegevens naar een externe dienst overbrengen moet gepaard gaan met een duidelijk voorbeeld en geïnformeerde bevestiging. Vage of veelvuldige bevestigingen leiden tot gedachteloos doorklikken; de interface moet de gegevens, de bestemming en het gevolg precies tonen.
Voer de agent uit in een beperkte omgeving
Procesisolatie, standaard uitgeschakelde netwerktoegang, tijdelijke opslag en inloggegevens met beperkte rechten begrenzen de gevolgen van een fout. Deze controles nemen promptinjectie niet weg; ze voorkomen dat een gemanipuleerd antwoord rechtstreeks uitmondt in brede toegang.
Wat kunnen gebruikers en beheerders doen voor de beveiliging van AI-chatbots?
Gebruikers moeten elke AI-koppeling beschouwen als een nieuwe ontvanger van privégegevens. Beheerders moeten de gegevensstroom en handelingen van de agent vóór ingebruikname beoordelen en tijdens gebruik bewaken.
Voor persoonlijk gebruik:
- Selecteer alleen het benodigde bericht of bestand; geef geen toegang tot de volledige geschiedenis.
- Controleer de verwerkingslocatie, bewaartermijn, het gebruik voor training en de manier waarop gegevens kunnen worden gewist.
- Laat het automatisch verzenden van berichten of bestanden uitgeschakeld, tenzij er een duidelijke noodzaak voor is.
- Houd het apparaat, de browser en apps actueel en controleer gevoelige rechten opnieuw.
Voor organisaties:
- Stel een dreigingsmodel op dat een kwaadwillende afzender, een onbetrouwbaar groepslid, de modeldienst, een extern hulpmiddel en een besmet apparaat afzonderlijk behandelt.
- Registreer aanroepen van hulpmiddelen, wijzigingen van rechten, uitvoerbestemmingen en gebruikersbevestigingen met zo weinig mogelijk gevoelige gegevens.
- Test vijandige invoer in berichten, documenten, geciteerde tekst, afbeeldingen met tekst en opgehaalde inhoud.
- Definieer voor elke agent grenzen voor handelingen, verzoekfrequentie en toegestane bestemmingen, plus een noodstop.
- Kies standaard voor veilig stoppen: als het beleid onduidelijk is, moet de agent stoppen in plaats van te gokken.
Geen enkele lijst biedt volledige veiligheid. Het resultaat hangt af van de implementatie, het model, de instellingen, het gebruikersgedrag en de ontwikkeling van aanvalsmethoden. Goede verdediging is gericht op het beperken van bevoegdheden, het zichtbaar maken van afwijkingen en het begrenzen van schade.
Kunnen versleutelde berichtenapps en AI samen veilig zijn?
Ja, versleutelde berichtenapps en AI kunnen samengaan met beheersbare risico's, mits de assistent minimale toegang heeft en geen gevoelige handelingen zonder bevestiging uitvoert. Toch schept de koppeling van elk model aan privé-inhoud een nieuwe vertrouwensgrens, die niet achter het label E2EE mag worden verborgen.
Een ontwerp met minder risico houdt verwerking zo veel mogelijk op het apparaat, beperkt de context tot expliciete gebruikersselecties, maakt het geheugen kortstondig en scheidt uitvoerhulpmiddelen. Ook lokale verwerking biedt geen absolute garantie: een besmet apparaat, onveilig model of ruime rechten blijven risico's opleveren.
De gebruiker moet kunnen begrijpen welke gegevens naar het model gaan, waar het model draait, hoelang het iets bewaart en wat het kan doen. Als een product die vragen niet helder beantwoordt, mag uit termen als ‘privé-AI’ geen definitieve veiligheidsconclusie worden getrokken.
Protocoldocumentatie of een overeenkomende apphash is geen beveiligingstest van een gekoppelde assistent. Beoordeel vóór het inschakelen van een koppeling de rechten en gegevensroute van die specifieke functie afzonderlijk. Eén geslaagde test dekt op zichzelf evenmin alle toekomstige invoer.
Veelgestelde vragen
Stopt end-to-endversleuteling promptinjectie?
Nee. End-to-endversleuteling verbergt het bericht voor tussenpersonen tussen afzender en bevoegde ontvangers. Als een bevoegde bot, een app op het apparaat of malware toegang heeft tot de ontsleutelde tekst, kan die deze verwerken. Promptinjectie beperken vereist grenzen aan de rechten, hulpmiddelen, het geheugen en de uitvoer van de agent.
Is privéchats laten samenvatten door AI gevaarlijk?
Het risico hangt af van de architectuur. Het lokaal samenvatten van één geselecteerd bericht, zonder geheugen of uitvoerhulpmiddelen, heeft een kleinere risicoreikwijdte dan een cloudbot met blijvende toegang tot alle chats. Controleer vóór gebruik de verwerkingslocatie, gegevensbewaring, reikwijdte van rechten en mogelijkheid tot automatisch verzenden.
Kan een bericht van een bekende contactpersoon promptinjectie bevatten?
Ja. Vertrouwen in de identiteit van de afzender is niet hetzelfde als vertrouwen in al diens inhoud: het account kan zijn overgenomen of de afzender kan onbedoeld schadelijke tekst hebben doorgestuurd. Alle inhoud die de agent leest, moet als onbetrouwbare gegevens worden behandeld, ook in een geauthenticeerd en versleuteld gesprek.
Verbergen LVR1 en LGS1 gegevens voor een AI-assistent?
In gesprekken die daadwerkelijk met LVR1 of LGS1 en een actieve E2EE-status worden beschermd, zijn deze protocollen bedoeld om de inhoud te verbergen voor tussenpersonen zonder sleutel. Als de gebruiker of app een assistent toestaat ontsleutelde berichten te lezen, blokkeren deze protocollen die geautoriseerde toegang niet. De beveiliging van de assistent moet daarom los van de beveiliging van berichtoverdracht worden beoordeeld.
Wat is de eerste stap om gegevenslekken door een AI-agent te beperken?
Beperk eerst de toegang van de agent: alleen het geselecteerde bericht, alleen voor die beurt en zonder automatisch verzenden. Voeg vervolgens voor gevoelige handelingen een voorbeeld en menselijke bevestiging toe, beperk uitvoerbestemmingen en registreer aanroepen van hulpmiddelen. Deze lagen verminderen het risico, maar bieden geen absolute garantie.


