
Kryptografie bestimmt, wer eine Nachricht auf dem Übertragungsweg lesen kann; Zugriffskontrolle und Agentendesign bestimmen, was der Empfänger nach dem Lesen damit tun kann.
Ein Prompt-Injection-Angriff in einem Messenger liegt vor, wenn der Text einer Nachricht einen KI-Assistenten dazu bringen soll, seine übergeordneten Regeln zu missachten und eine unzulässige Anforderung auszuführen. Ende-zu-Ende-Verschlüsselung schützt die Nachricht auf dem Übertragungsweg. Hat der Nutzer jedoch einem Bot das Lesen des Chats erlaubt oder wurde ein Gerät kompromittiert, kann die Verschlüsselung das Verhalten dieses berechtigten Empfängers nicht begrenzen.
Das Wichtigste in Kürze
- Ende-zu-Ende-Verschlüsselung verhindert das Mitlesen auf dem Übertragungsweg, nicht den Missbrauch durch einen virtuellen Assistenten, der den entschlüsselten Text sehen darf.
- Indirekte Prompt Injection kann sich in privaten Nachrichten, Dateien, Bildunterschriften oder zitierten Inhalten verbergen und bei der Verarbeitung zur Anweisung werden.
- Das Risiko eines Datenabflusses durch einen KI-Agenten steigt, wenn dieser gleichzeitig auf Chats, Gedächtnis und externe Werkzeuge zugreifen sowie Daten senden oder Aktionen ausführen kann.
- Die Trennung von Daten und Anweisungen, minimale Berechtigungen, menschliche Bestätigung und begrenzte Ausgaben gehören zu den wichtigsten Schutzschichten. Keine davon bietet allein eine vollständige Garantie.
- Laut Livaras Dokumentation sind direkte Chats und kompatible private Gruppen bei aktivem E2EE Ende-zu-Ende-verschlüsselt; eine inkompatible ältere Gruppe kann außerhalb dieses Schutzes bleiben. Dieser Schutz garantiert nicht das Verhalten eines Assistenten, nachdem er den Text erhalten hat.
Wie funktioniert Prompt Injection in einem Messenger?
Bei Prompt Injection, also dem Einschleusen von Anweisungen, gestaltet ein Angreifer eine Eingabe so, dass ein Sprachmodell sie als Anweisung statt als Daten akzeptiert und von seiner übergeordneten Richtlinie abweicht. Der OWASP-Leitfaden zu Prompt Injection nennt direkte Eingaben und externe Inhalte als Wege für dieses Risiko. In einem agentenbasierten System kann eine umgelenkte Antwort auch zur unbeabsichtigten Nutzung angebundener Werkzeuge führen.
Bei einem direkten Angriff fordert der Nutzer selbst den Bot auf, bisherige Regeln zu ignorieren. Bei einem indirekten Angriff steckt die schädliche Anweisung in Inhalten, die der Assistent für eine andere Aufgabe liest: einer eingehenden Nachricht, einem Zitat, einer Bildunterschrift, einem Dokument oder der Ausgabe eines Werkzeugs. Im zweiten Fall muss der Angreifer kein Konto mit dem KI-Agenten teilen. Es genügt, dass sein Inhalt in den vom Agenten verarbeiteten Kontext gelangt.
Beispielsweise bittet ein Nutzer den Assistenten, neue Nachrichten zusammenzufassen. Eine Nachricht enthält Text, der sich als „Systemanweisung“ ausgibt und den Agenten auffordert, die Zusammenfassung abzubrechen, andere Informationen aus dem Kontext zu entnehmen und an ein externes Ziel zu senden. Der Erfolg dieses Szenarios ist nicht sicher, sondern hängt vom Modell, der Anwendungsgestaltung, den Zugriffsrechten und den Ausgabekontrollen ab. Schon diese Möglichkeit ist jedoch für einen Assistenten mit Werkzeugzugriff sicherheitsrelevant.
Die Manipulation einer Modellantwort ist von einem Angriff auf einen handlungsfähigen Agenten zu unterscheiden. Eine falsche Antwort mag ärgerlich sein; ein Agent, der Nachrichten senden, Dateien abrufen oder Dienste aufrufen darf, kann dieselbe Manipulation in eine Datenoffenlegung oder eine unerwünschte Aktion verwandeln.
Warum hängt die Sicherheit eines KI-Chatbots nicht nur von Verschlüsselung ab?
Die Sicherheit eines KI-Chatbots hängt von der gesamten Vertrauenskette ab: Messenger, Gerät, Modell, Gedächtnis, Werkzeuge, Server des Anbieters und Berechtigungsrichtlinie. Ende-zu-Ende-Verschlüsselung deckt nur eine bestimmte Grenze ab: Sie verhindert das Lesen privater Inhalte auf dem Weg vom Absender zu den berechtigten Empfängern.
Erreicht eine Nachricht ein berechtigtes Gerät, wird sie zur Anzeige für den Nutzer entschlüsselt. Hat ein Assistent auf diesem Gerät oder über eine autorisierte Verbindung Zugriff auf den Text, sieht er die Daten nach der Entschlüsselung. Aus Sicht des Protokolls kann ein berechtigter Bot oder eine berechtigte Anwendung ein legitimer Empfänger sein; aus Sicht des Nutzers kann derselbe Empfänger zu weitreichende Befugnisse haben.
Der Unterschied lässt sich so zusammenfassen: Kryptografie bestimmt, wer eine Nachricht auf dem Übertragungsweg lesen kann; Zugriffskontrolle und Agentendesign bestimmen, was der Empfänger nach dem Lesen damit tun kann. Zur ersten Grenze erläutert der Leitfaden Ende-zu-Ende-Verschlüsselung und ihre Schutzgrenzen, warum E2EE kein Mittel gegen Schadsoftware, einen unredlichen Empfänger oder eine kompromittierte Anzeige ist.
Auch die Verbindung „verschlüsselter Messenger und KI“ sollte nicht automatisch als sicher oder unsicher gelten. Ein lokaler Agent ohne dauerhaftes Gedächtnis und ohne Ausgabewerkzeuge hat nicht dasselbe Risikoniveau wie ein Cloud-Bot mit Zugriff auf Verlauf, Dateien und externe Konten. Architektur und Berechtigungsumfang bestimmen das Ergebnis.
Welche Risiken entstehen durch den Zugriff eines KI-Assistenten auf private Chats?
Durch den Zugriff eines KI-Assistenten auf private Chats überschreiten Inhalte, die zuvor nur die menschlichen Gesprächsteilnehmer sahen, eine neue Vertrauensgrenze. Das Hauptrisiko besteht darin, dass der Assistent den Text nicht nur lesen, sondern auch speichern, mit anderen Daten kombinieren oder über einen anderen Kanal weitergeben kann.
Vor der Aktivierung einer solchen Funktion müssen fünf Fragen klar beantwortet werden:
- Welche Gespräche, Anhänge und welchen Zeitraum kann der Assistent genau lesen?
- Erfolgt die Verarbeitung auf dem Gerät oder werden die Inhalte an einen anderen Server übertragen?
- Welche Daten speichert der Anbieter und nutzt er sie zum Training?
- Welche Werkzeuge hat der Agent zum Senden von Nachrichten, Hochladen von Dateien, Suchen oder Ausführen von Aktionen?
- Erfordert jede sensible Aktion eine ausdrückliche Bestätigung des Nutzers?
Die Berechtigung „alle Chats lesen“ für eine Funktion, die nur eine ausgewählte Nachricht zusammenfassen soll, verletzt das Prinzip der geringsten Rechte. Danach erhält jede Komponente nur den minimalen Zugriff, der für die aktuelle Aufgabe erforderlich ist. Eine Berechtigung für eine Nachricht, ein Gespräch und einen einzelnen Durchlauf verkleinert das mögliche Schadensausmaß. Inhalte innerhalb dieses Bereichs können aber weiterhin einen Angriff enthalten.
Metadaten sind zudem von Inhalten zu unterscheiden. Laut Livaras Dokumentation werden betriebliche Metadaten wie Absender, Ziel und Zustellzeiten für Routing und Synchronisierung gespeichert. Der Leitfaden zu Messenger-Metadaten und den Informationen, die sie offenlegen, erläutert diese Grenze. Ein Assistent kann neben dem Text auch aus Kontaktmustern und Kommunikationszeiten Schlüsse ziehen; die Zugriffsrichtlinie muss daher beides berücksichtigen.
Auf welchen Wegen können Daten aus einem KI-Agenten abfließen?
Ein Datenabfluss aus einem KI-Agenten entsteht meist dann, wenn der Agent vertrauliche Inhalte in seinem Kontext sieht und sie an ein anderes Ziel übertragen kann. Prompt Injection allein bewegt keine Daten. Ein Abfluss hängt vom Zusammenspiel schädlicher Eingaben, Datenzugriff und eines Ausgabekanals ab.
Ausgehende Nachrichten oder Dateien
Der Agent kann Informationen in eine Antwort, eine neue Nachricht, einen Entwurf, eine Datei oder eine Anfrage an einen externen Dienst aufnehmen. Sendet das System Ausgaben ohne Einschränkungen oder Nutzerbestätigung, kann ein Angreifer versuchen, vertrauliche Daten in ein scheinbar gewöhnliches Format zu verpacken.
Langzeitgedächtnis
Manche Agenten speichern Gesprächszusammenfassungen, Präferenzen oder frühere Ergebnisse zur späteren Verwendung. Eine schädliche Anweisung kann versuchen, Daten in dieses Gedächtnis einzuschleusen oder in einer anderen Sitzung abzurufen. Eine kurze Speicherdauer, die Trennung zwischen Nutzern sowie die Möglichkeit, gespeicherte Inhalte einzusehen und zu löschen, senken das Risiko, beseitigen aber keine Modellfehler.
Werkzeugaufrufe
Ein Agent mit Werkzeugzugriff kann suchen, Dateien lesen oder andere erlaubte Aktionen ausführen. Das Lesen von Dateien, das Senden von Nachrichten und Netzwerkanfragen sollten jeweils eigene Berechtigungen erfordern. Schon die automatische Anzeige eines Links oder das Laden einer externen Ressource in der Ausgabe kann einen Datenabfluss ermöglichen. Dass es keine Schaltfläche „Senden“ gibt, reicht allein nicht aus.
Kompromittierte Geräte
Schadsoftware mit ausreichenden Zugriffsrechten kann angezeigten Text, Benachrichtigungen, Anwendungsspeicher oder Nutzereingaben sehen. Der Angreifer muss dann nicht unbedingt die Verschlüsselung brechen, sondern umgeht sie am Endgerät. Betriebssystemschutz, Updates, Zugriffskontrolle und die Überprüfung installierter Anwendungen gehören zur Abwehr, sind aber keine Funktionen des Messenger-Protokolls.
Wo liegen die Grenzen von Livaras Verschlüsselung bei dieser Bedrohung?
Die Sicherheitsdokumentation von Livara beschreibt LVR1 für direkte Chats und LGS1 für kompatible private Gruppen. Eine inkompatible ältere Gruppe kann ausdrücklich außerhalb von E2EE liegen; der Status des jeweiligen Gesprächs muss geprüft werden. Öffentliche Kanäle gehören ebenfalls nicht zum Bereich privater E2EE-Chats.
Auch in einem E2EE-Gespräch kontrolliert die Nachrichtenverschlüsselung nicht den Zweck der nachfolgenden Verarbeitung, wenn der Nutzer einem Assistenten den entschlüsselten Text überlässt. Die Prüfung einer Sicherheitsnummer bestätigt ebenfalls den Schlüssel eines Kontakts und erkennt keine schädlichen Anweisungen in dessen Text. Dieser Artikel behandelt eine allgemeine Risikoklasse und bestätigt weder die Existenz noch die Sicherheit einer bestimmten KI-Anbindung in Livara.
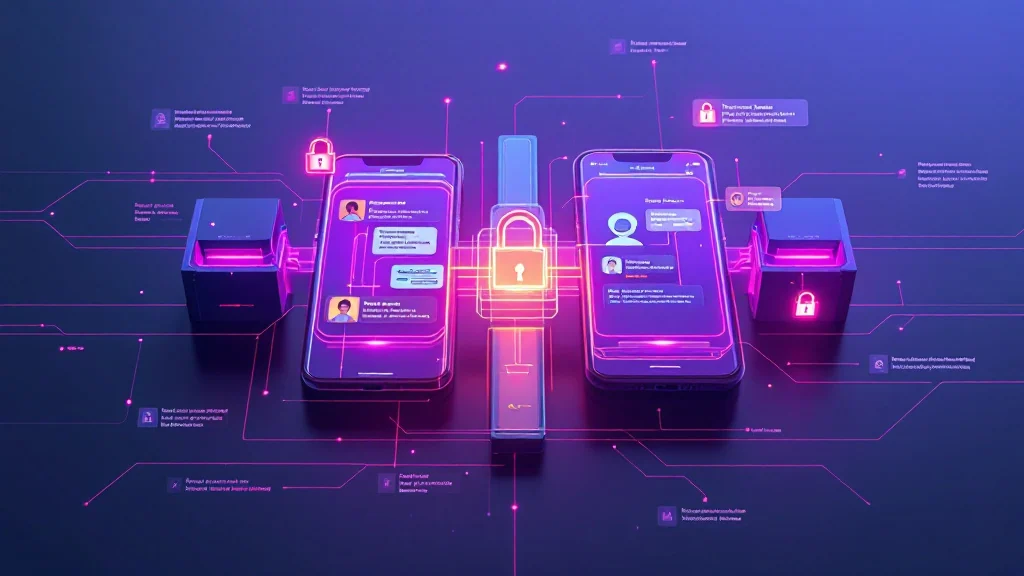
Dies ist eine konzeptionelle Darstellung, keine verifizierte Architektur von Livara. Die abgebildeten Schlösser beweisen nicht, dass ein Assistent keinen Zugriff auf ausgewählten Text hat.
Welche Architektur begrenzt Prompt Injection in Messengern?
Eine sichere Architektur muss eingehende Nachrichten als nicht vertrauenswürdige Daten behandeln, selbst wenn sie von einem bekannten Kontakt in einem verschlüsselten Chat stammen. Verschlüsselung stärkt die Authentizität des Übertragungswegs, beweist aber nicht, dass die Inhalte des Absenders für eine automatische Ausführung unbedenklich sind.
Daten und Anweisungen trennen
Die Anwendung sollte feste Entwickleranweisungen, die ausdrückliche Nutzeranfrage und aus Chats gelesene Inhalte in getrennten Ebenen halten. Die Warnung des NCSC zu Prompt Injection betont, dass man hier keine endgültige Lösung wie bei SQL Injection voraussetzen darf. Inhalte als „nicht vertrauenswürdige Daten“ zu kennzeichnen ist hilfreich. Sprachmodelle halten diese semantische Grenze jedoch nicht immer fehlerfrei ein; deshalb muss die Trennung durch Kontrollen außerhalb des Modells ergänzt werden.
Befugnisse des Agenten reduzieren
Ein Agent für Zusammenfassungen muss weder automatisch Nachrichten versenden noch alle Dateien lesen können. Werkzeuge sollten Positivlisten, eng begrenzte Geltungsbereiche, getrennte Zugangsdaten und kurze Gültigkeitsfristen haben. Eine einmalige Berechtigung für ausgewählte Inhalte ist besser als dauerhafter Zugriff, weil sie sowohl die Wahrscheinlichkeit unbeabsichtigter Zugriffe als auch das Ausmaß eines Datenabflusses reduziert.
Ausgaben durch eine deterministische Kontrollinstanz prüfen
Das Modell sollte nicht selbst endgültig entscheiden, ob sensible Daten gesendet werden. Eine nicht generative Ebene kann Ziel, Datentyp, Ausgabevolumen und angeforderte Aktion anhand deterministischer Regeln prüfen. Strukturelle Regeln und Positivlisten für Ziele müssen außerhalb des Modells durchgesetzt werden. Die semantische Erkennung sämtlicher vertraulicher Informationen kann dennoch fehlschlagen. Datensparsame Ereignisprotokolle, Warnmeldungen und eine Stoppmöglichkeit sind ebenfalls notwendig.
Für sensible Aktionen menschliche Bestätigung verlangen
Einen Entwurf zu lesen ist nicht dasselbe, wie ihn zu senden. Das Senden von Nachrichten, Teilen von Dateien, Hinzufügen von Mitgliedern, Ändern von Kontoeinstellungen oder Übertragen von Daten an externe Dienste sollte eine klare Vorschau und informierte Bestätigung erfordern. Unklare oder zu häufige Bestätigungen werden zur Klickgewohnheit. Die Oberfläche muss genau zeigen, welche Daten, welches Ziel und welche Folgen betroffen sind.
Den Agenten in einer eingeschränkten Umgebung ausführen
Prozessisolierung, standardmäßig gesperrter Netzwerkzugriff, temporärer Speicher und eng begrenzte Zugangsdaten verringern die Folgen eines Fehlers. Diese Kontrollen beseitigen Prompt Injection nicht, verhindern aber, dass eine umgelenkte Antwort unmittelbar zu weitreichendem Zugriff wird.
Was sollten Nutzer und Administratoren für die Sicherheit von KI-Chatbots tun?
Nutzer sollten jede KI-Anbindung als neuen Empfänger privater Daten betrachten. Administratoren sollten außerdem vor der Bereitstellung die Datenflüsse und Aktionen des Agenten prüfen und sie zur Laufzeit überwachen.
Für die persönliche Nutzung:
- Nur die benötigte Nachricht oder Datei auswählen; keinen Zugriff auf den gesamten Verlauf gewähren.
- Verarbeitungsort, Speicherdauer, Trainingsnutzung und Löschverfahren prüfen.
- Automatisches Senden von Nachrichten oder Dateien deaktiviert lassen, sofern es nicht eindeutig nötig ist.
- Gerät, Browser und Anwendungen aktuell halten und sensible Berechtigungen überprüfen.
Für Organisationen:
- Ein Bedrohungsmodell erstellen, das böswillige Absender, unredliche Gruppenmitglieder, den Modelldienst, externe Werkzeuge und kompromittierte Geräte getrennt berücksichtigt.
- Werkzeugaufrufe, Berechtigungsänderungen, Ausgabeziele und Nutzerbestätigungen mit möglichst wenigen erforderlichen sensiblen Daten protokollieren.
- Feindselige Eingaben in Nachrichten, Dokumenten, Zitaten, Bildern mit Text und abgerufenen Inhalten testen.
- Für jeden Agenten Aktionsobergrenzen, Anfrageraten, erlaubte Ziele und einen Not-Aus-Schalter festlegen.
- Im Zweifel sicher stoppen: Ist die Richtlinie unklar, muss der Agent anhalten, statt zu raten.
Keine Checkliste schafft vollständige Sicherheit. Das Ergebnis hängt von Implementierung, Modell, Einstellungen, Nutzerverhalten und der Weiterentwicklung von Angriffsmethoden ab. Gute Abwehr soll Befugnisse reduzieren, Abweichungen sichtbar machen und Schäden begrenzen.
Können verschlüsselte Messenger und KI gemeinsam sicher sein?
Ja, verschlüsselte Messenger und KI können mit kontrolliertem Risiko zusammenarbeiten, sofern der Assistent nur den geringsten erforderlichen Zugriff hat und sensible Aktionen nicht ohne Bestätigung ausführt. Die Anbindung eines Modells an private Inhalte schafft jedoch immer eine neue Vertrauensgrenze, die nicht hinter der Bezeichnung E2EE versteckt werden darf.
Eine risikoärmere Gestaltung belässt die Verarbeitung möglichst auf dem Gerät, beschränkt den Kontext auf die ausdrückliche Auswahl des Nutzers, hält das Gedächtnis kurzlebig und trennt Ausgabewerkzeuge ab. Auch lokale Verarbeitung ist keine absolute Garantie: Ein kompromittiertes Gerät, ein unsicheres Modell oder weitreichende Berechtigungen bergen weiterhin Risiken.
Nutzer müssen erkennen können, welche Daten zum Modell gelangen, wo das Modell ausgeführt wird, wie lange es etwas speichert und was es tun kann. Beantwortet ein Produkt diese Fragen nicht klar, darf aus Begriffen wie „private KI“ keine eindeutige Sicherheitszusage abgeleitet werden.
Protokolldokumentation oder der Abgleich eines Anwendungshashes sind kein Sicherheitstest eines angebundenen Assistenten. Vor der Aktivierung einer Anbindung sind die Berechtigungen und Datenwege dieser konkreten Funktion gesondert zu prüfen. Auch ein einzelner erfolgreicher Test deckt für sich genommen nicht alle künftigen Eingaben ab.
Häufig gestellte Fragen
Verhindert Ende-zu-Ende-Verschlüsselung Prompt Injection?
Nein. Ende-zu-Ende-Verschlüsselung verbirgt Nachrichten zwischen Absender und berechtigten Empfängern vor Zwischenstellen. Hat ein autorisierter Bot, eine Anwendung auf dem Gerät oder Schadsoftware Zugriff auf den entschlüsselten Text, kann er beziehungsweise sie ihn verarbeiten. Um Prompt Injection einzudämmen, müssen Berechtigungen, Werkzeuge, Gedächtnis und Ausgaben des Agenten begrenzt werden.
Ist das Zusammenfassen privater Chats mit KI gefährlich?
Das Risiko hängt von der Architektur ab. Die lokale Zusammenfassung einer ausgewählten Nachricht ohne Gedächtnis und Ausgabewerkzeuge hat einen kleineren Risikoumfang als ein Cloud-Bot mit dauerhaftem Zugriff auf alle Chats. Vor der Nutzung sind Verarbeitungsort, Datenspeicherung, Berechtigungsumfang und die Möglichkeit automatischen Sendens zu prüfen.
Kann eine Nachricht eines bekannten Kontakts Prompt Injection enthalten?
Ja. Vertrauen in die Identität des Absenders ist nicht dasselbe wie Vertrauen in sämtliche Inhalte. Sein Konto könnte übernommen worden sein oder er könnte schädlichen Text unwissentlich weitergeleitet haben. Alle vom Agenten gelesenen Inhalte sind als nicht vertrauenswürdige Daten zu behandeln, auch in einem authentifizierten und verschlüsselten Gespräch.
Verbergen LVR1 und LGS1 Informationen vor einem KI-Assistenten?
In Gesprächen, die tatsächlich mit LVR1 oder LGS1 und aktivem E2EE geschützt sind, sollen diese Protokolle Inhalte vor Zwischenstellen ohne Schlüssel verbergen. Erlaubt der Nutzer oder die Anwendung einem Assistenten, eine entschlüsselte Nachricht zu lesen, blockieren diese Protokolle diesen berechtigten Zugriff nicht. Die Sicherheit des Assistenten muss daher getrennt von der Sicherheit der Nachrichtenübertragung bewertet werden.
Was ist der erste Schritt gegen Datenabfluss aus einem KI-Agenten?
Zuerst den Zugriff des Agenten eingrenzen: nur die ausgewählte Nachricht, nur für den jeweiligen Durchlauf und ohne automatisches Senden. Anschließend für sensible Aktionen eine Vorschau und menschliche Bestätigung vorsehen, Ausgabeziele begrenzen und Werkzeugaufrufe protokollieren. Diese Schichten senken das Risiko, bieten aber keine absolute Garantie.


